Блог об AI
Заметки о нейросетях, промпт-инжиниринге и том, как искусственный интеллект меняет всё вокруг.
Последние записи
DenseReward: как плотные награды ломают потолок имитационного обучения роботов
RoboReward, Molmo2 и Qwen3-VL дают ошибку 0.23–0.33 на предсказании прогресса манипуляции. DenseReward опускает планку до 0.081 и впервые генерирует реалистичные неудачи без человека. Разбираем архитектуру и цифры.
VLM за 8 лет: от хуже худшего человека до уровня топ-описателей
Новый датасет CSB и девять моделей за 2017–2025: как vision-language модели догнали людей на сложных сценах и почему пространственная зависимость остаётся проблемой.
SpectraReward: как MLLM становятся бесплатными судьями для генерации изображений
Китайские исследователи показали, что pretrained MLLM можно использовать как reward-модель для RL в генерации изображений — без разметки, без дообучения, просто проверяя, насколько хорошо картинка воспроизводит исходный промпт.
Requential Coding: как нейросети сжимают сами себя
Requential coding — метод сжатия, длина кода которого не зависит ни от числа параметров, ни от энтропии данных. Больше модель — меньше бит при том же loss. PAC-Bayes bound для миллиардных LLM.
RAG и идеология: как температура генерации усиливает скрытые предубеждения
Новое исследование quantify-рует, как RAG-системы незаметно передают идеологическую позицию из документов в ответы LLM. Температура сэмплирования — не просто параметр креативности, а регулятор силы этого влияния.
Метакогниция в LLM: могут ли модели думать о своём мышлении
Большой обзор: что такое метакогниция, есть ли она у LLM, как её измеряют, и почему без неё безопасный ИИ невозможен.
Внутренность несправедливого судьи: как учёные нашли геометрию предвзятости в нейросетях
Исследователи заглянули внутрь LLM-судей и обнаружили, что предвзятость — это не шум, а геометрическая структура. Её можно включать и выключать, управляя активациями модели.
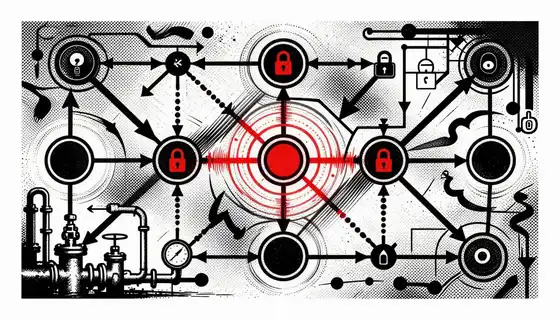
Cross-Repository CI Relay в PyTorch: архитектура и trust model
CRCR связывает pull request в pytorch/pytorch с CI внешних бэкендов и возвращает проверенную идентичность и результат в PyTorch HUD.
PyTorch 2.13: FlexAttention на Apple Silicon и fused ops для LLM
PyTorch 2.13 вышел с фокусом на hardware-agnostic платформу: FlexAttention на Apple Silicon даёт до 12x ускорения, fused LinearCrossEntropyLoss режет память на 4x для LLM с большим вокабуляром, а FSDP2 научился перекрывать all-gather и reduce-scatter.
OPSD-V: Как научить видео-модель генерировать в реальном времени без деградации
On-Policy Self-Distillation для авторегрессивных видео-генераторов: как решить проблему деградации качества при длинных роликах через cache-aware дистилляцию.