Блог об AI
Заметки о нейросетях, промпт-инжиниринге и том, как искусственный интеллект меняет всё вокруг.
Последние записи
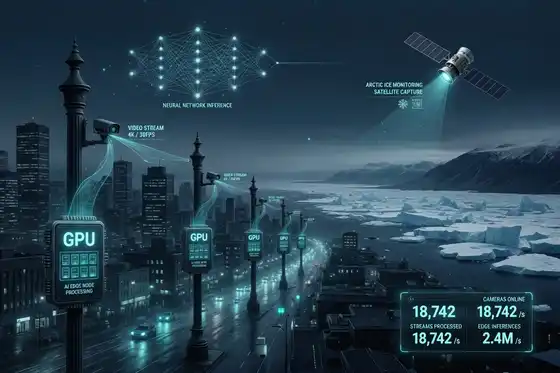
Edge AI: как нейросети захватывают города и спутники
Два новых проекта показывают, как AI уходит из дата-центров прямо на улицы и в космос: городская сеть камер на Jetson и спутниковая нейросеть на FPGA.
Спекулятивное декодирование: SpecKV ускоряет LLM на 56%
SpecKV динамически подбирает длину спекуляции при декодировании LLM, ускоряя генерацию на 56% и работая с любым уровнем квантизации модели.
OpenAI DevDay 2025: платформа, агенты и новые модели — что строить дальше
OpenAI DevDay 2025 показал, как компания видит будущее разработки: приложения внутри ChatGPT, агенты везде, AI пишет код и генерирует видео через API.
HiFloat4: как Китай обходит санкции через эффективность чипов
Huawei разработала HiFloat4 — 4-битный формат для обучения LLM на Ascend-чипах, который обходит западный MXFP4 по всем метрикам. Санкции парадоксально становятся драйвером инноваций.
CUDA-агент ByteDance: ИИ пишет код для обучения ИИ
ByteDance и Университет Цинхуа создали CUDA Agent — ИИ, который пишет GPU-код для обучения будущих ИИ-моделей. 92% на самом сложном уровне KernelBench.
AI Co-Mathematician: Google научил ИИ быть соавтором математиков
Google DeepMind представил AI Co-Mathematician — интерактивную рабочую среду, где агентная ИИ-система выступает соавтором математика, помогая с идеями, поиском литературы, вычислениями и доказательствами.
MoE-модели тратят экспертов впустую — UniPool это исправляет
UniPool заменяет раздельные экспертные пулы в каждом слое MoE на единый глобальный пул — и добивается лучших результатов с меньшим числом параметров.
Рейтинги LLM не работают: почему лидерборды вводят нас в заблуждение
Анализ 89 000 сравнений на Arena показал: 72% голосов взаимно отменяются, а топ-50 моделей неотличимы. Решение — портфолио рейтингов по языкам.
Безопасность Kimi K2.5: лучший китайский ИИ и его риски
Kimi K2.5 — лучший открытый ИИ из Китая — сопоставим с GPT-5.2 по возможностям, но его защитные механизмы можно обойти за $500 и 10 часов. Подробный разбор независимого аудита безопасности.
Прогресс ИИ обгоняет прогнозы: Аджейя Котра признала ошибку
Аджейя Котра, один из самых авторитетных прогнозистов в сфере ИИ, признала: AI-агенты развиваются быстрее её предсказаний. Opus 4.6 уже держит 12-часовые задачи — на год раньше срока.